Importer un site web / une page web
Écrit par Stanislas
Dernière mise à jour Il y a 16 jours
Aperçu
La fonctionnalité d'importation de sites et de pages web vous permet d'ajouter du contenu web externe directement dans votre base de connaissances. Swiftask explore le contenu, le découpe en segments indexables et le prépare pour une recherche rapide par les agents IA.
Vous pouvez importer deux types de contenus web :
- Site web : extrait le contenu de plusieurs pages en explorant automatiquement les liens internes.
- Page web : extrait le contenu d'URL précises, avec options pour les sous-URL, la pagination ou l'import groupé par fichier CSV.
Une fois importée, la source de données est immédiatement exploitable dans le Chat, les Agents IA et les Projets.
Comprendre la différence
Import de site web :
- Analyse et importe plusieurs pages d'un domaine complet ou d'une sous-arborescence
- Détecte automatiquement les liens et évalue le volume total de pages
- Idéal pour les documentations techniques, les blogs et les bases de connaissances
Import de page web :
- Récupère exclusivement le contenu des URL ou listes CSV indiquées
- Plus rapide et ciblé sur des pages de référence spécifiques
- Idéal pour des articles isolés, des chartes ou des guides réglementaires
Prérequis
Avant d'importer du contenu web, assurez-vous de disposer de :
- Un compte Swiftask actif
- L'accès à la section Connaissances
- L'autorisation de créer des sources de données dans votre espace de travail
- L'URL publique du site web ou de la page web à importer
Guide étape par étape
1. Accéder à Connaissances
Dans le menu latéral gauche, cliquez sur Connaissances.
2. Ouvrir le menu d'importation
Cliquez sur le bouton Importer en haut à droite pour ouvrir la liste des options d'importation.
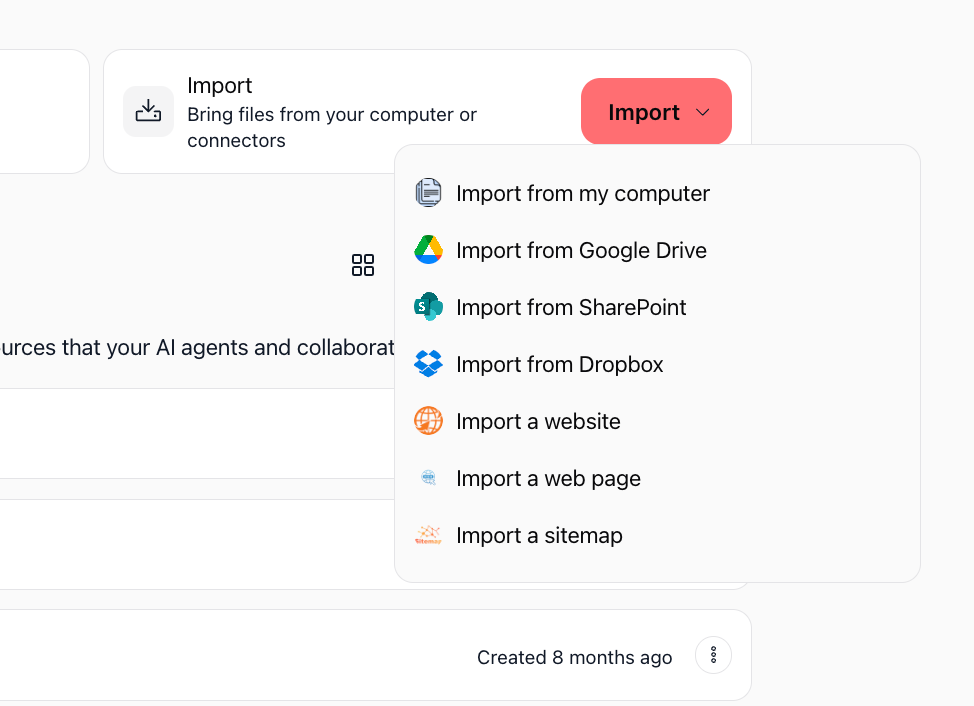
Sélectionnez Importer un site web ou Importer une page web selon vos besoins.
Importer un site web
1. Saisir l'URL du site web et les détails
Dans le champ Nom, attribuez un nom clair à votre source de données (ex. : « My website »). À l'étape 1 Enter Website URL, saisissez l'adresse complète avec le protocole (ex. : https://blog.getbootstrap.com/), puis cliquez sur Check.
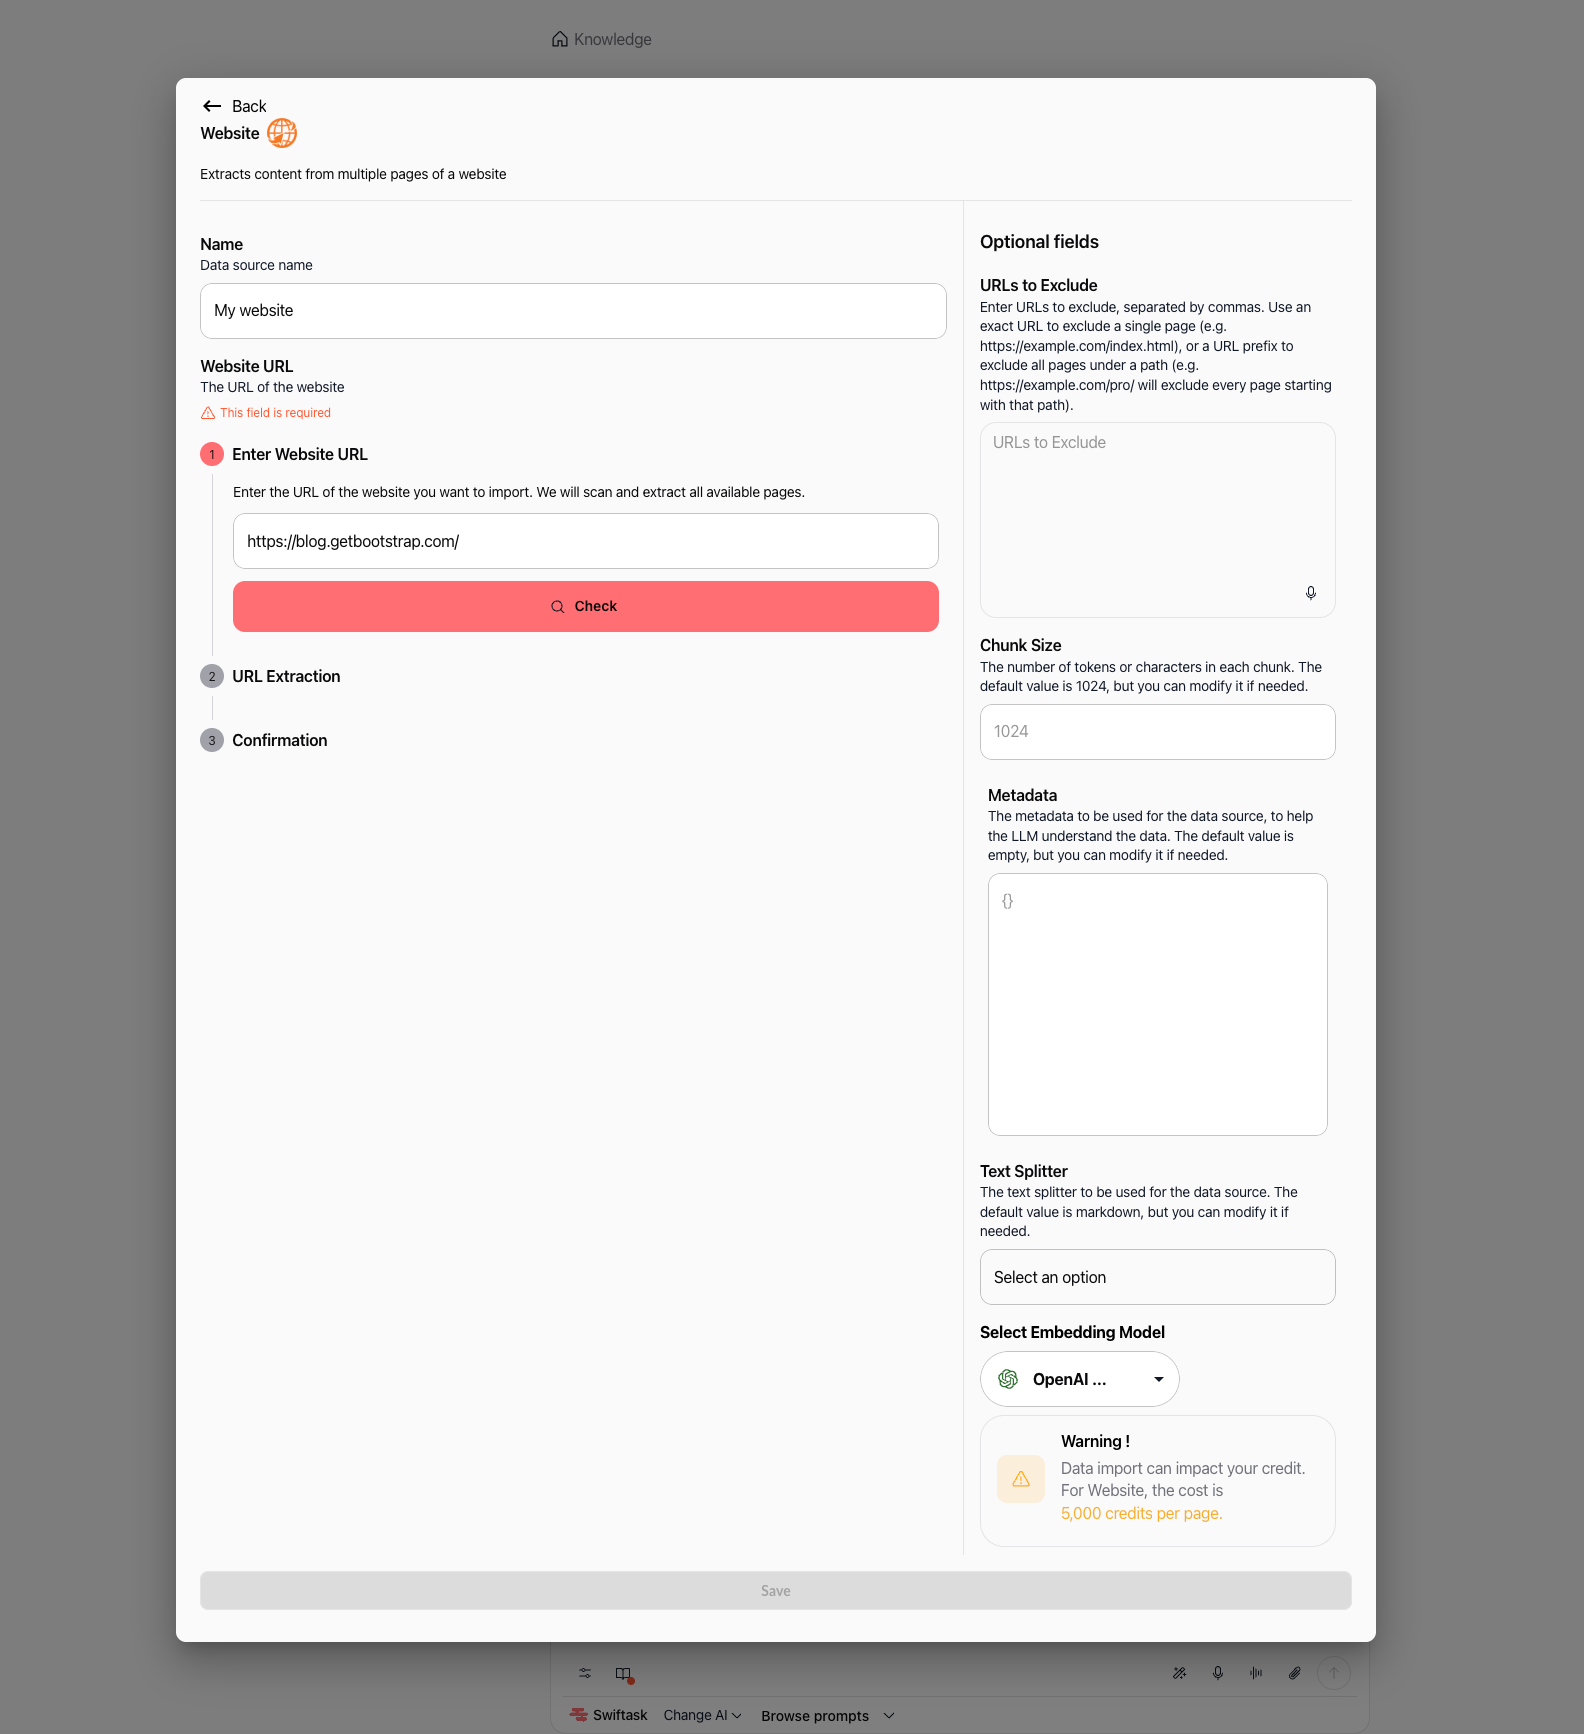
2. Vérifier les URL extraites et le coût d'importation
Swiftask analyse le site et affiche le nombre de pages détectées ainsi que l'estimation des crédits nécessaires (ex. : « 147 URLs found » et « 735.00K Credits », calculés sur la base de 5 000 crédits par page).
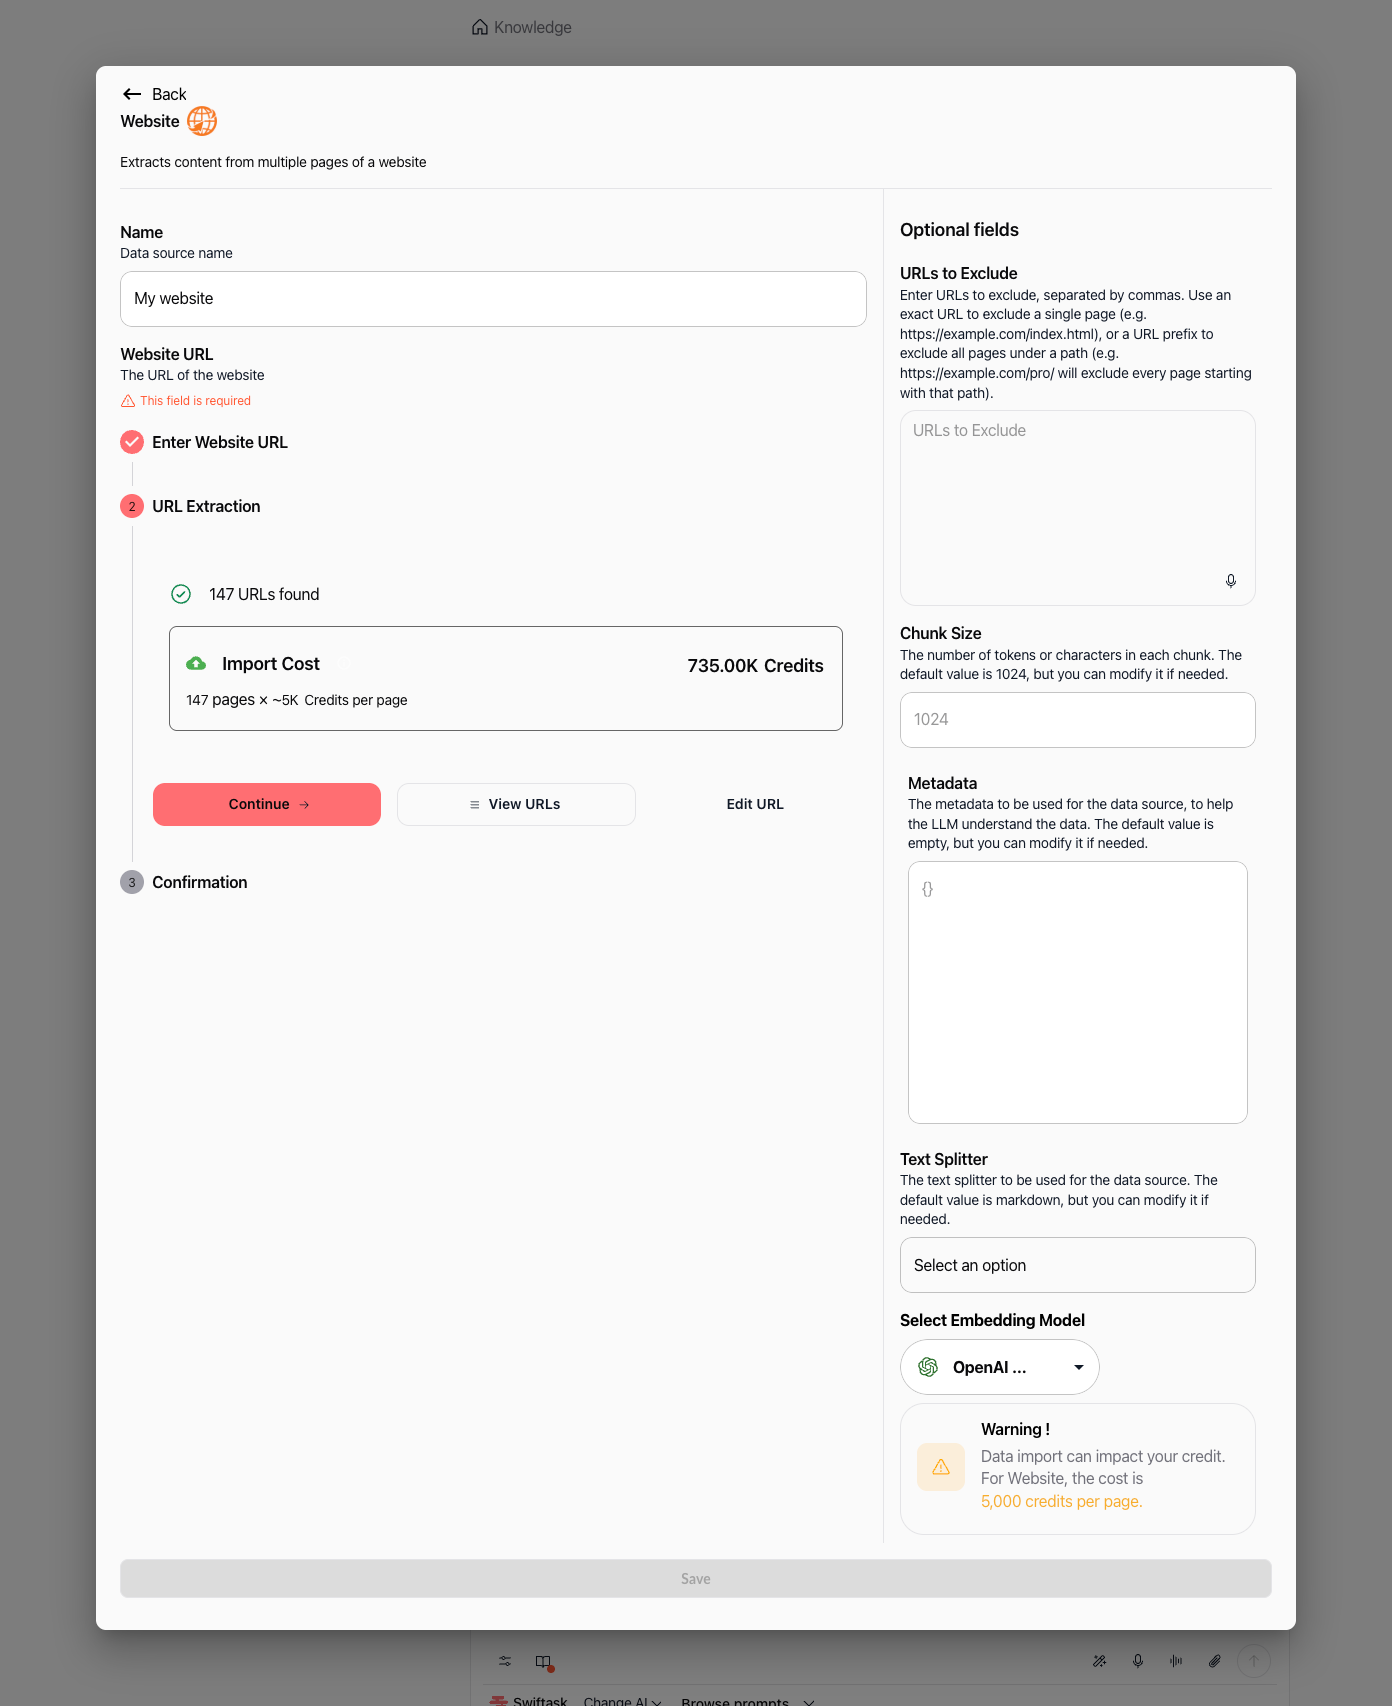
Cliquez sur View URLs pour examiner la table des liens découverts et vérifier la pagination avant de continuer.
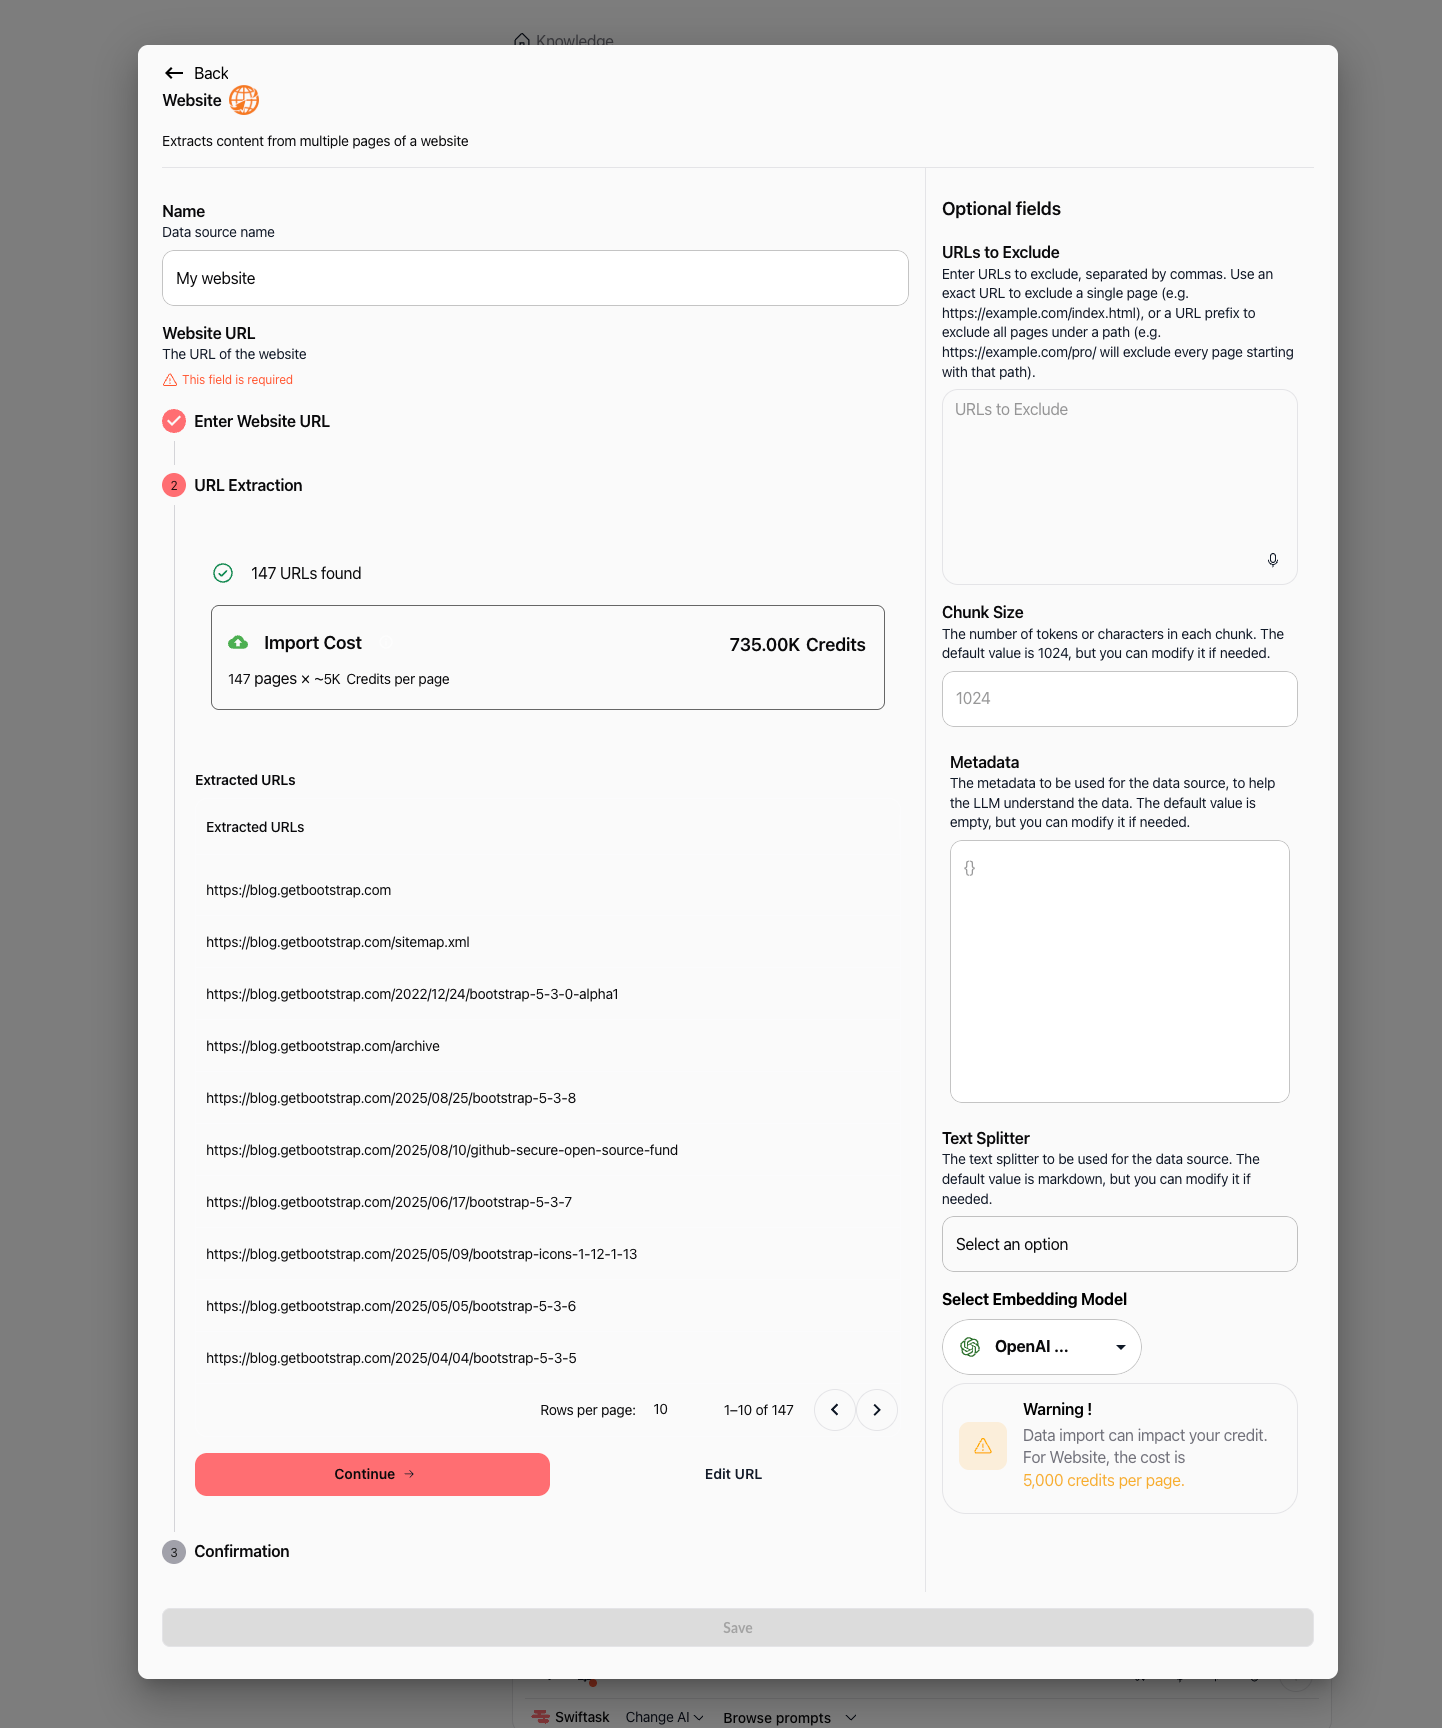
3. Configurer les paramètres optionnels
Dans le panneau de droite, ajustez les options selon vos préférences :
- URLs to Exclude : saisissez les URL ou préfixes séparés par des virgules à exclure de l'exploration.
- Chunk Size : définissez la taille des segments (par défaut : 1024).
- Metadata : ajoutez des balises JSON pour enrichir le contexte d'analyse IA.
- Text Splitter : choisissez le mode de découpage (par défaut : markdown).
- Select Embedding Model : choisissez le modèle de vectorisation (par défaut : OpenAI).
Cliquez sur Continue → lorsque la configuration est prête.
4. Confirmer l'importation et enregistrer
Vérifiez le récapitulatif Import Summary (URL source, volume de pages et total des crédits). Cliquez sur Confirm Import.
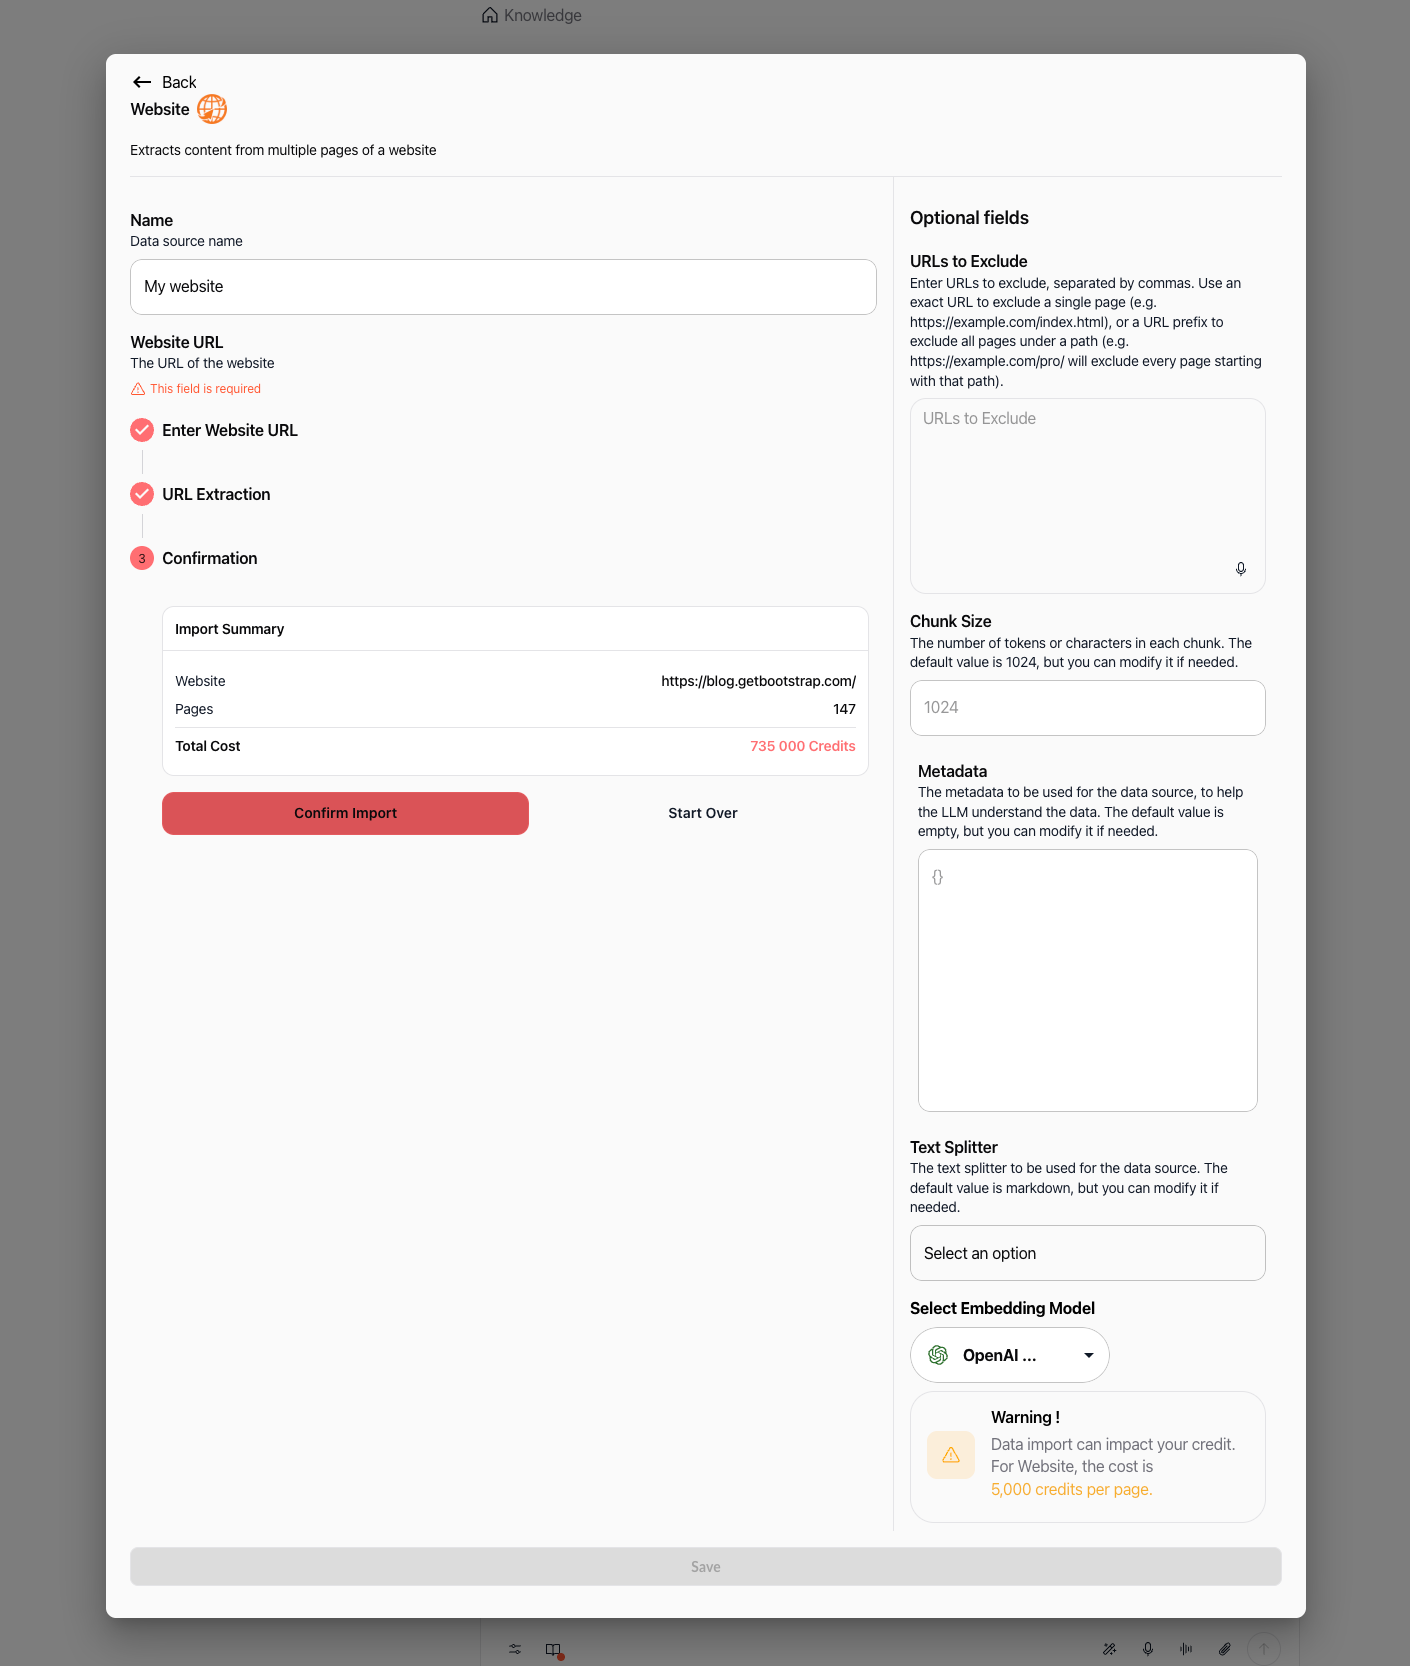
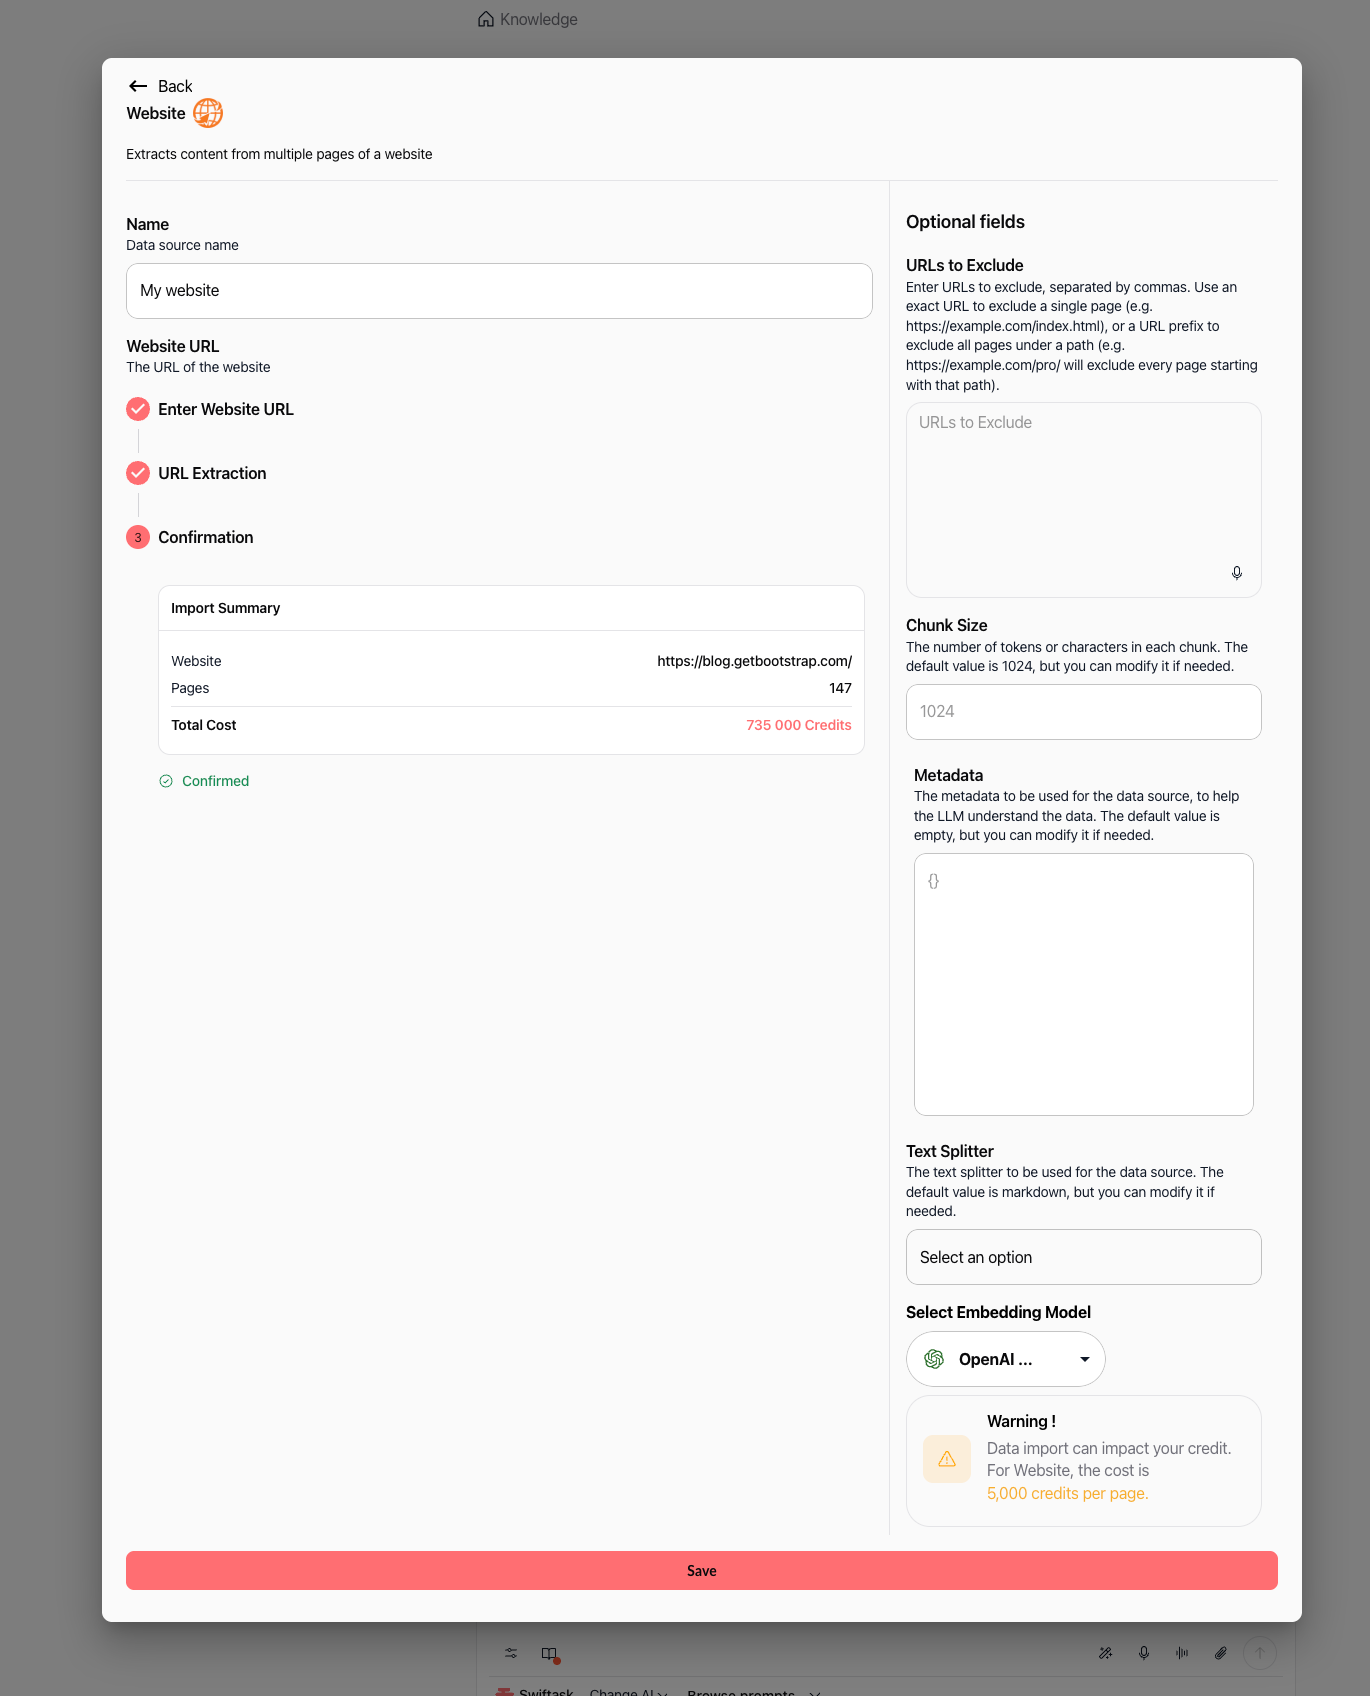
Une fois confirmée, la mention Confirmed s'affiche avec une coche verte. Cliquez sur le bouton Save en bas pour lancer le traitement.
5. Suivre la progression de l'indexation
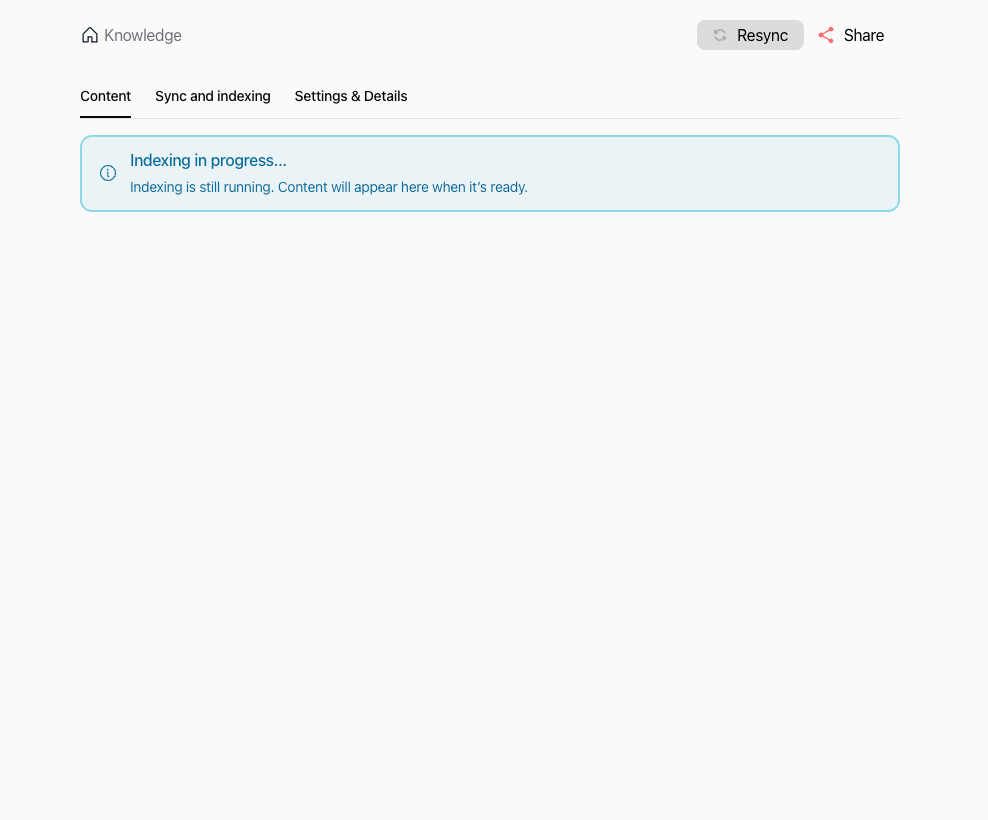
Swiftask traite les pages en arrière-plan. Pendant l'indexation dans la base vectorielle, un bandeau d'alerte indique Indexing in progress....
6. Consulter le contenu importé et prévisualiser les fragments
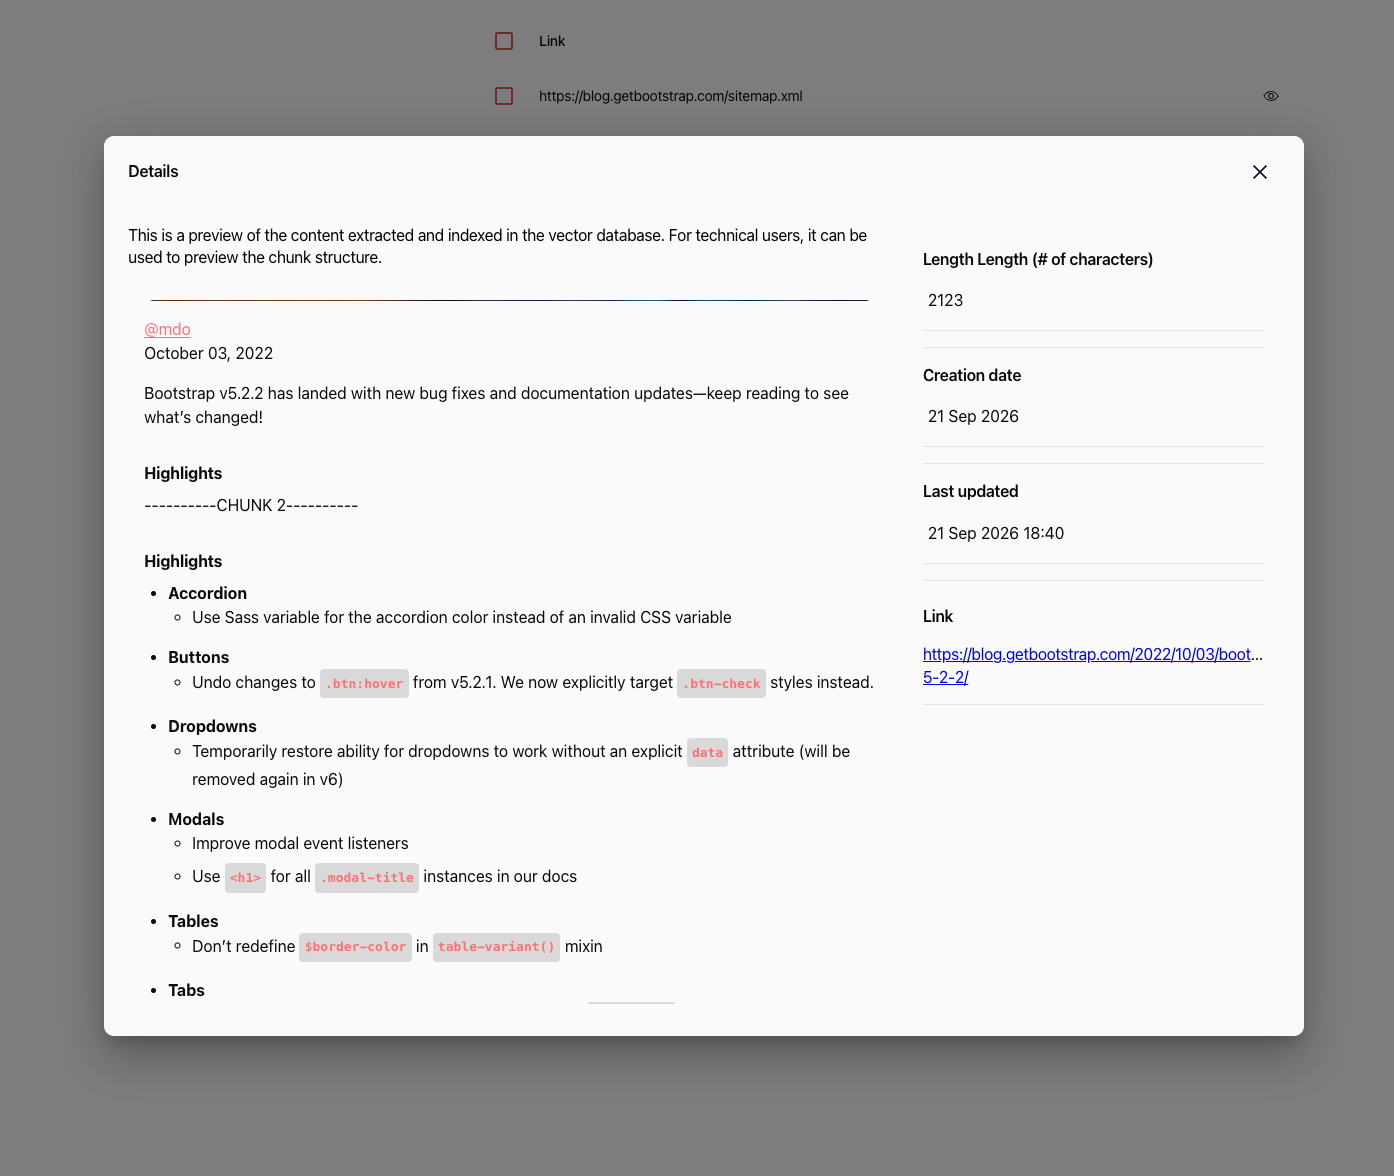
Ouvrez l'onglet Content pour afficher la liste des URL indexées, filtrer par nom ou vérifier la pagination.
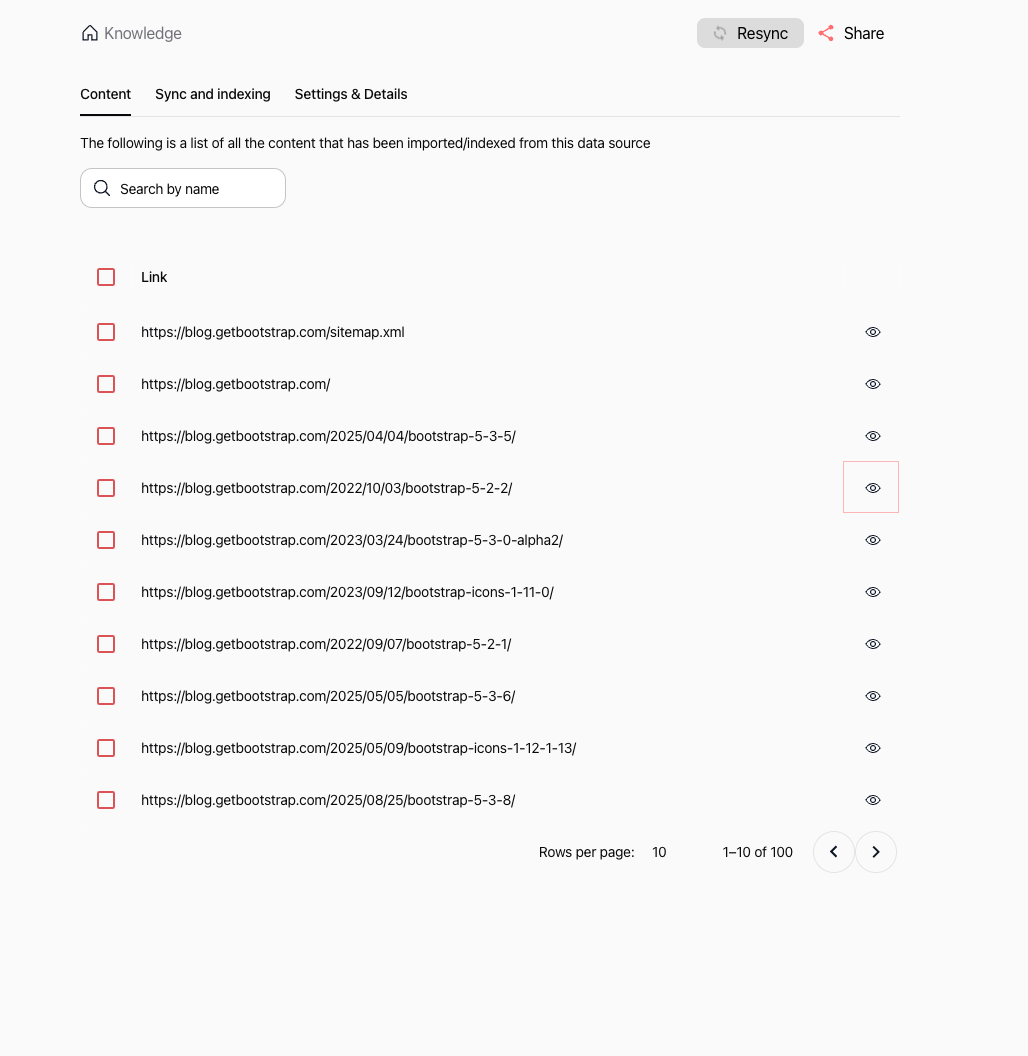
Cliquez sur l'icône en œil à côté d'une page pour ouvrir la fenêtre modale Details. Vous pouvez visualiser les segments de texte extraits, le nombre de caractères, les horodatages et le lien direct.
7. Gérer les paramètres de la source de données
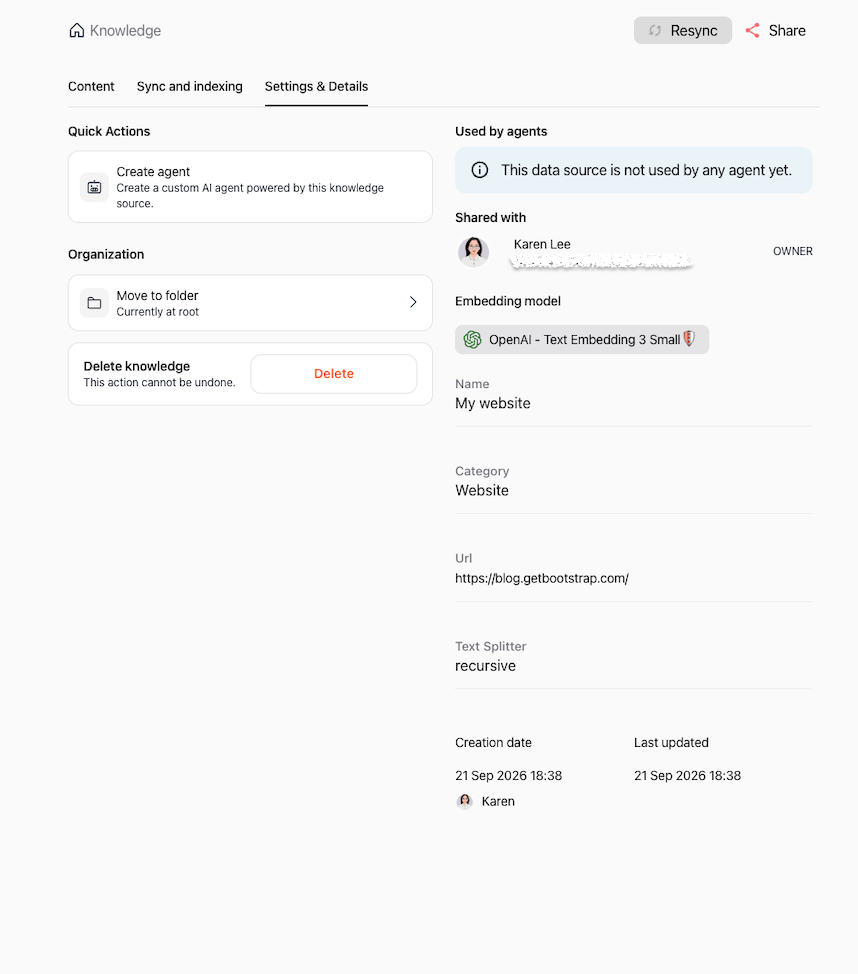
Cliquez sur l'onglet Settings & Details pour vérifier les propriétés de la source, la déplacer dans un dossier, générer un agent IA dédié ou supprimer la ressource.
Importer une page web
1. Configurer les détails de la page web et les options
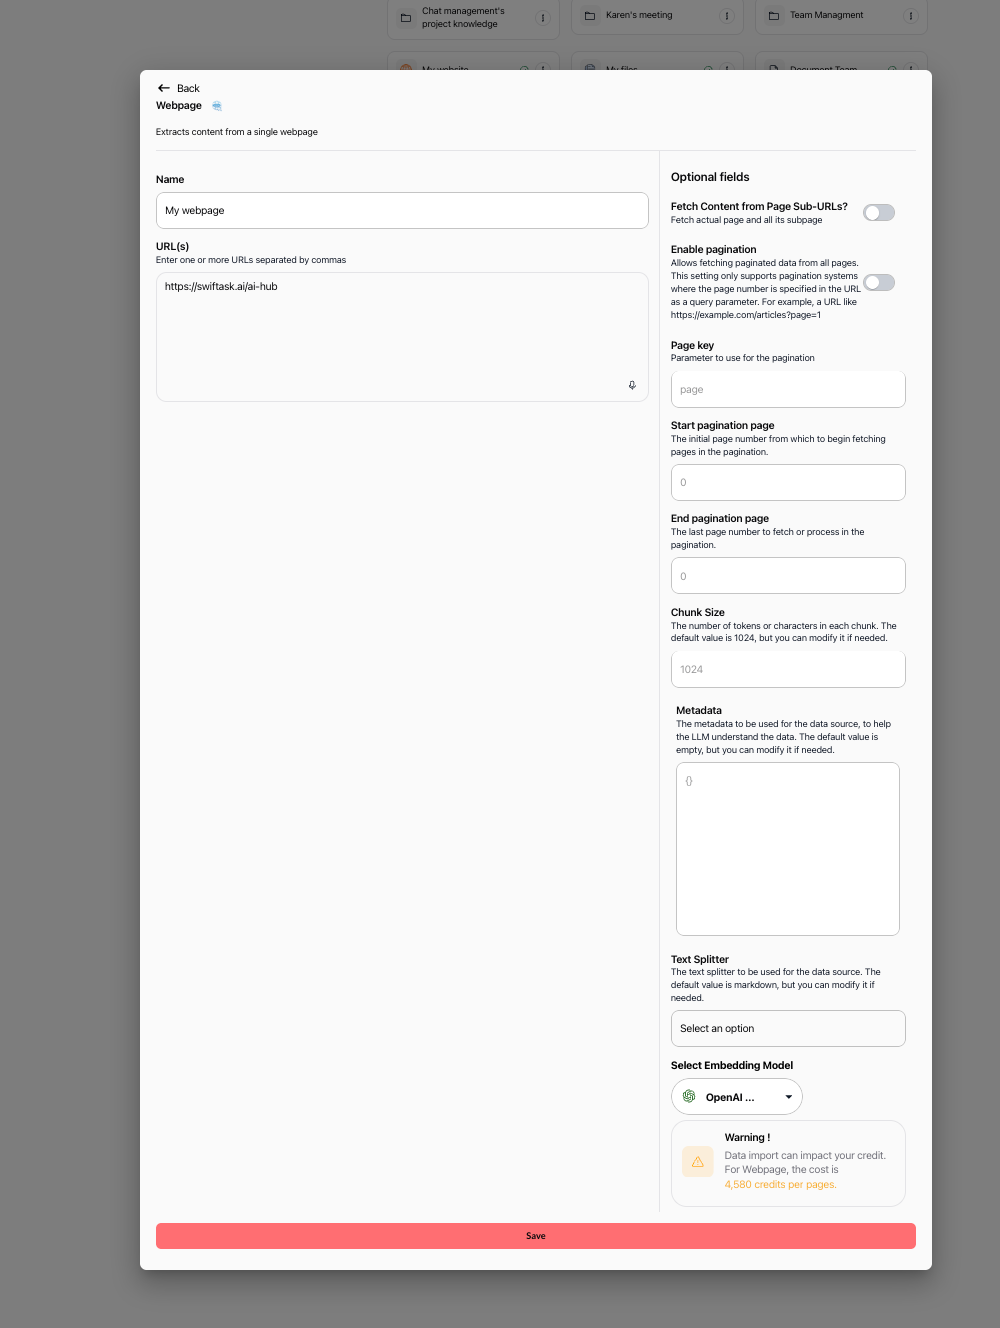
Dans le menu d'importation, cliquez sur Importer une page web. Entrez un nom descriptif (ex. : « My webpage ») et renseignez une ou plusieurs URL séparées par des virgules dans le champ URL(s) (ex. : https://swiftask.ai/ai-hub).
Dans le panneau de droite, paramétrez les options :
- Fetch Content from Page Sub-URLs? : activez l'interrupteur pour explorer les sous-pages rattachées à l'URL.
- Enable pagination : activez si la page comporte des paramètres de pagination (ex. :
?page=1), puis indiquez la clé Page key, la page de départ et la page de fin. - Chunk Size, Metadata, Text Splitter, Select Embedding Model : ajustez les réglages avancés.
- Avertissement : prenez note de la consommation de crédits (4 580 crédits par page).
Cliquez sur le bouton Save pour lancer l'importation.
2. Suivre la progression de l'importation
Dans la liste de vos Connaissances, la carte de la source affiche un cercle orange avec une coche pendant le traitement et l'indexation.
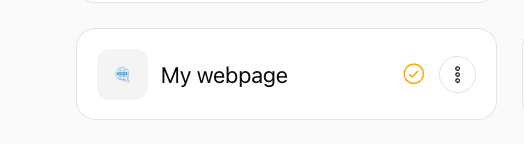
Dès que l'indexation est terminée, l'icône passe au vert pour signaler que les contenus sont prêts à être interrogés.
3. Consulter le contenu de la page web importée
Ouvrez la source de données depuis votre liste pour explorer les fragments de texte, filtrer les entrées et examiner les métadonnées.
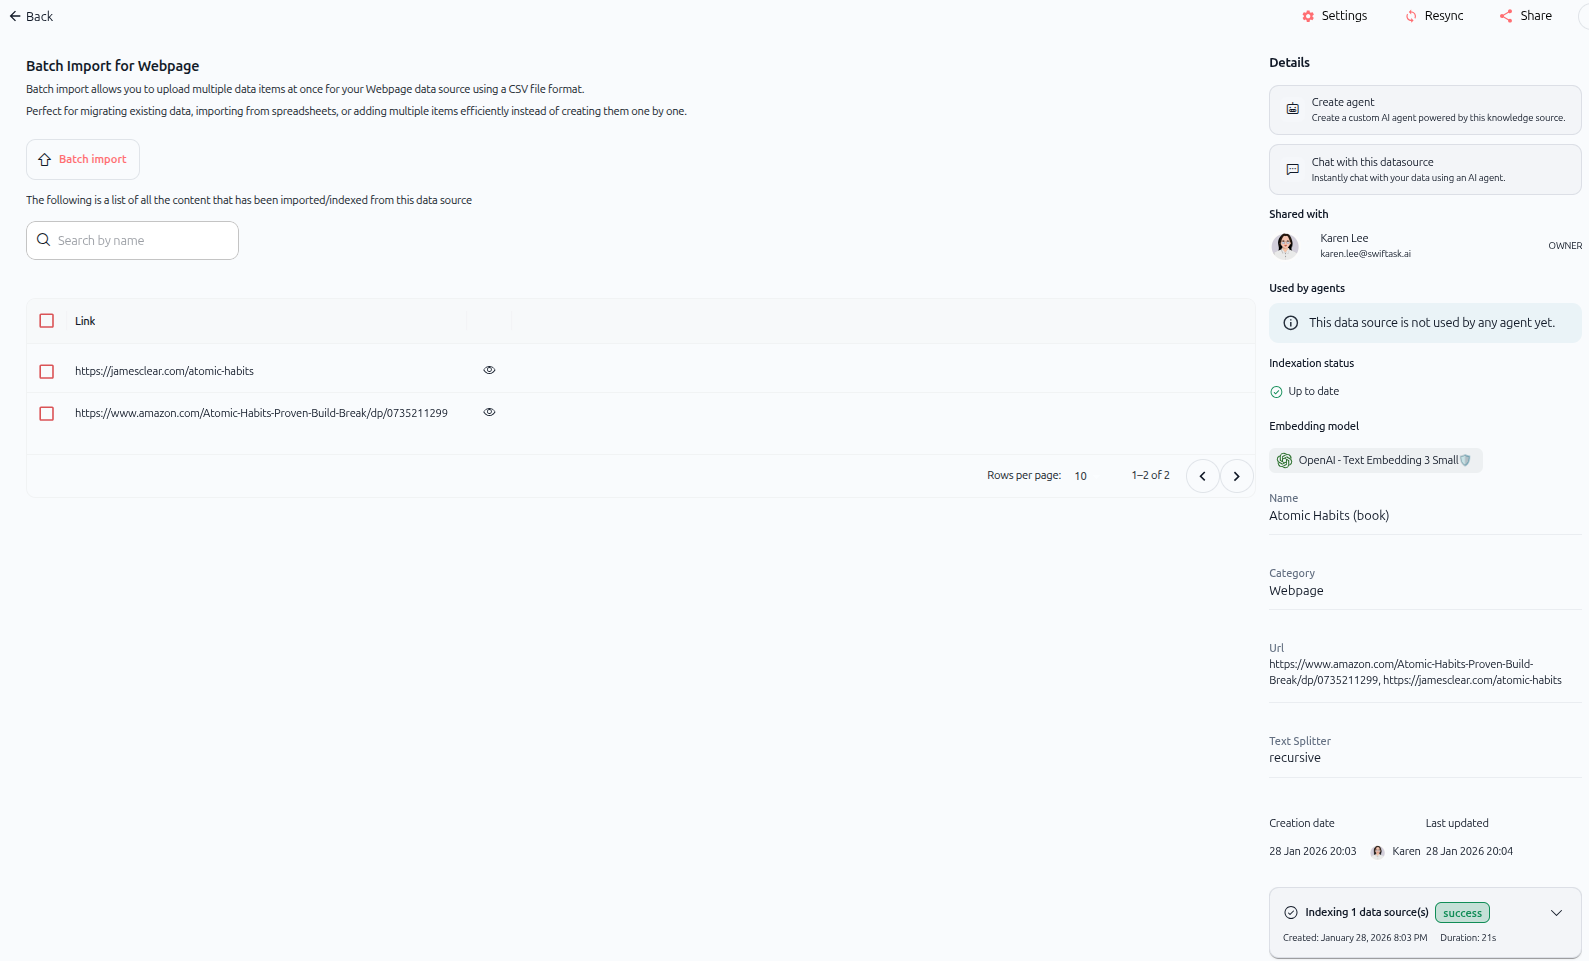
Importer des pages web par lot via un fichier CSV
Lorsque vous devez importer de nombreuses pages précises, vous pouvez téléverser un fichier CSV pour les ajouter en une seule opération.
1. Ouvrir la fenêtre modale d'import par lot
Accédez à la vue d'import par lot pour déposer votre fichier CSV comprenant les URL cibles et leurs paramètres.
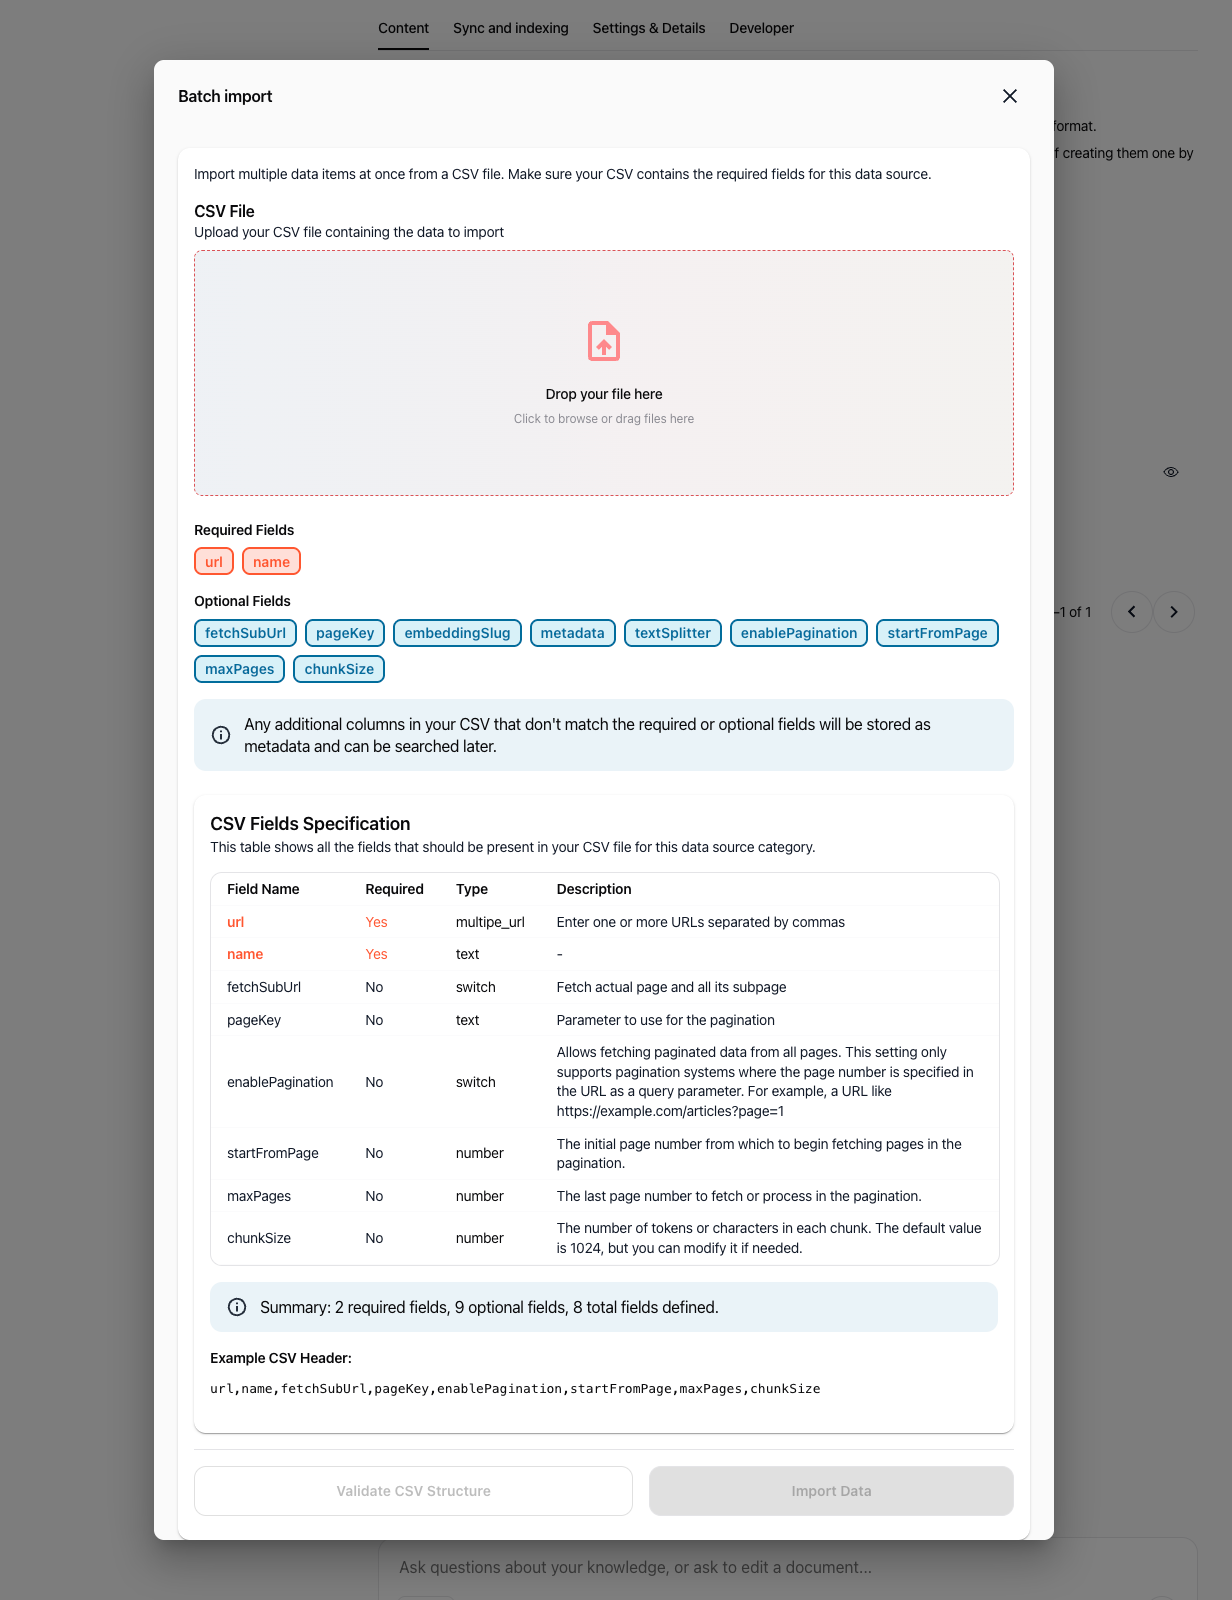
2. Vérifier la spécification des colonnes CSV
Votre fichier CSV doit contenir les colonnes obligatoires et peut intégrer des paramètres avancés :
- Champs obligatoires :
url: une ou plusieurs URL séparées par des virgules.name: nom de l'élément ou de la source de données.
- Champs optionnels :
fetchSubUrl:trueoufalsepour récupérer les sous-pages.pageKey: paramètre de requête pour la pagination (ex. :page).enablePagination:trueoufalsepour activer la pagination.startFromPage: numéro de page de départ.maxPages: dernière page à récupérer.chunkSize: taille des segments en jetons ou caractères (par défaut : 1024).embeddingSlug: identifiant du modèle d'embedding.textSplitter: méthode de découpage (ex. : markdown, recursive).metadata: métadonnées JSON additionnelles. Toute colonne supplémentaire dans le CSV est automatiquement conservée comme métadonnée.
Exemple d'en-tête CSV :
url,name,fetchSubUrl,pageKey,enablePagination,startFromPage,maxPages,chunkSize3. Valider et importer
Cliquez sur Validate CSV Structure pour contrôler le format, puis sur Import Data pour exécuter l'import groupé.
Cas d'usage pratiques
- Bibliothèque de documentation technique : importez l'intégralité du site documentaire de votre produit pour permettre aux agents de support de répondre aux utilisateurs avec les guides et procédures officielles.
- Veille concurrentielle : importez les pages de présentation et grilles tarifaires de vos concurrents pour faciliter l'analyse comparative par les agents marketing.
- Suivi réglementaire : chargez des pages spécifiques de directives juridiques ou de conformité afin d'appuyer vos analyses contractuelles sur des références fiables.
- Recherches documentaires en masse : exploitez l'import CSV pour intégrer simultanément plusieurs dizaines d'URL sectorielles au sein d'un agent de synthèse.
Astuces & bonnes pratiques
- Excluez les chemins superflus : renseignez le champ URLs to Exclude pour ignorer les pages de connexion, paniers d'achat ou archives sans valeur documentaire.
- Estimez le coût en crédits : contrôlez toujours le volume prévisionnel de pages et le total des crédits avant de confirmer l'exploration d'un site complet.
- Contrôlez les fragments extraits : cliquez sur l'icône en œil pour vérifier que le texte extrait ne contient pas de bannières de cookies ou d'éléments parasites de navigation.
- Privilégiez l'import par lot : pour un volume important d'URL, préparez un fichier CSV afin de standardiser vos imports et gagner du temps.
Dépannage
- Échec de validation de l'URL :
- Cause : le site est privé, protégé par un dispositif anti-bot ou l'URL est mal formatée.
- Solution : assurez-vous que le lien s'ouvre en navigation privée, inclut le préfixe
https://et accepte l'indexation publique.
- Aucun texte extrait :
- Cause : la page repose exclusivement sur du rendu JavaScript côté client ou uniquement sur des visuels sans texte indexable.
- Solution : privilégiez une version HTML statique ou collez directement le contenu dans une ressource Document.
- Coût en crédits plus élevé que prévu :
- Cause : le site dispose de nombreuses pages imbriquées ou paginées.
- Solution : restreignez le crawl via URLs to Exclude ou ciblez les pages clés via l'import de page web.
- Échec de validation du fichier CSV :
- Cause : en-têtes obligatoires manquants (
url,name) ou séparateurs non conformes. - Solution : vérifiez la correspondance stricte des noms de colonnes et l'encodage UTF-8 de votre fichier.
- Cause : en-têtes obligatoires manquants (
Ressources complémentaires
- Introduction à la base de connaissances : découvrez le rôle central des sources de données dans l'alimentation des agents IA et du Chat.
- Importer des documents / fichiers : apprenez à importer directement vos fichiers PDF, Word et tableurs locaux.
- Synchronisation automatique : automatisez l'actualisation de vos sources connectées.
Cela a-t-il été utile ?
Besoin d'aide supplémentaire ? Demander à l'équipe